采集云端会话,本地评估:用 Apache SkyWalking AI Sessionizer 分析 Amazon Bedrock AgentCore 上的 AI Agent
本文同时发布于 AWS Builder Center。英文版:Collect Cloud Sessions, Evaluate Locally。
本文用一个发布助手演示完整流程:让 Agent 修改配置、部署应用并查询结果,再检查这些工作是否达到要求。Agent 在 Amazon Bedrock AgentCore 上运行,Apache SkyWalking AI Sessionizer(asz)在云端记录执行过程。我们把记录拉到电脑上查看,再用本地 CLI 运行 judge,检查它是否完成了要求。
本文沿着同一个例子走五步:设计 Agent → 部署和采集 → 拉取并查看 → 运行 judge → 对照目标读结果。
1. Agent 要做什么
这个 Agent 的工作是发布 demo-v1。我们给它文件读写、配置验证、构建、部署和状态查询工具,让模型自己决定如何调用。
Agent 使用 LangGraph,运行在 AgentCore Runtime 上,实际调用 Amazon Bedrock 的 Nova Pro 模型。业务系统则是模拟的:配置、发布包、部署状态和验收申请都保存为文件,不会操作真实生产应用。
我们设计了七轮对话,让它既遇到正常任务,也遇到需求修改、权限拒绝和取消操作:
| 轮次 | 我们对 Agent 说什么 | 最后要检查什么 |
|---|---|---|
| 1 | 创建 staging 配置:两个副本、超时 300 秒,验证后先不要部署 | 文件确实写入,验证通过,没有部署 |
| 2 | 超时改为 600 秒,保持两个副本,重新验证 | 文件与验证结果都变成 600,而不只是回复“已修改” |
| 3 | 构建、部署到 staging,然后查询并核对配置 | 部署完成后,查询结果能确认版本、副本数和超时 |
| 4 | 按相同参数构建并部署 production,说明成功和失败部分 | 区分构建与部署;如果权限被拒绝,应如实说明 |
| 5 | 提交验收,确认是否批准,保留申请 ID | 区分“申请已提交”与“已经批准”;无法确认时保留未知状态 |
| 6 | 检查当前配置,提出从两个副本扩到四个的方案,等待确认 | 先检查再提方案,未经确认不修改 |
| 7 | 取消扩缩容,保留两个副本,总结结果 | 没有实施扩缩容,总结准确列出完成、失败和未确认事项 |
这些要求写在 scenarios/release.json 中,会作为真实用户消息发送给 Agent。右侧一列就是我们后面阅读 judge 结果时的检查清单。
模拟器会拒绝 production 部署,提交验收后也不会返回明确的批准结论。我们既检查业务目标是否完成,也检查 Agent 是否准确报告失败和未知状态。例如,production 部署失败时,Agent 应明确说明被拒绝,不能宣称发布成功。
2. 怎么部署和采集
部署这套示例
本机准备 Git、Go 1.27+、uv、OpenSSL、AWS CLI、OpenTofu 和正在运行的 Docker。AWS 账号需要基础设施部署权限,以及在 us-east-1 调用 us.amazon.nova-pro-v1:0 的权限。
git clone --branch main https://github.com/wu-sheng/aws-agentcore-asz-demo.git
cd aws-agentcore-asz-demo/examples/pull-judge
bash scripts/bootstrap.sh
export PATH="$PWD/.work/bin:$PATH"
bootstrap.sh 安装示例依赖并构建 asz。新示例位于独立目录,保留了上一篇文章的代码和部署方式。
如果尚未登录 AWS,先执行 aws login。下面的部署命令都在 examples/pull-judge/ 目录运行,把 YOUR_PUBLIC_IPV4 换成你的公网出口 IPv4;使用代理时填写代理的出口 IP。
aws sts get-caller-identity
.venv/bin/python scripts/prepare-cloud.py --client-ip YOUR_PUBLIC_IPV4

AGENT_IMAGE=ghcr.io/wu-sheng/aws-agentcore-asz-pull-judge-agent:b3e872bfb9a26fbd8bfac6eab6073d241b79c904 \
  bash scripts/up.sh
这里使用本次实测的镜像。脚本检查模型访问,复制镜像到 ECR,并创建 AgentCore Runtime、Fargate 上的 asz、EFS 和网络资源。部署会产生 AWS 资源费用,运行 Agent 会产生模型调用费用。部署完成后,资源清单保存在 .work/cloud/resources.txt。
配置执行记录和文件变化采集
AgentCore 中的 Agent
  ├─ 对话、模型调用、工具调用 ──→ 云端 asz
  └─ 工具造成的文件变化 ──→ 共享 EFS ──→ 云端 asz
                                            │
                                       本机按需 pull
                                            ↓
                                     本地查看和 judge
示例已配好两条采集路径:
- 执行记录:LangGraph 的追踪数据通过
LANGSMITH_ENDPOINT发给 asz 的接收端,包含用户输入、模型回复和工具调用。 - 文件变化:asz 的记录组件跟踪
write_file、build_release、deploy、submit_acceptance,把变化写入共享 EFS,由 asz 读取。
这两条采集路径把模型回复、工具结果和文件变化保存在同一条会话中。Agent 使用 Runtime IAM role 调用 Bedrock。云端只需要运行 Agent 和 asz 采集服务;评估所需的 Claude Code 或 Codex 在本机运行。
现在发送第一节设计的七轮请求:
.venv/bin/python scripts/cloud.py
脚本在同一个 AgentCore session 中逐轮调用 Agent,等待记录采集完成,并在第 1、5、7 轮后自动拉取快照 A、B、C。结束时会打印 .work/cloud-TIMESTAMP 目录:
turn-*.json:每轮请求和回复。checkpoints.json:三个快照的会话 ID 和标签。client/asz.yaml:下一步使用的本地配置。
3. 用 remote pull 获取数据,在本地查看
remote pull 将云端会话复制为本地快照。云端继续采集,本机保留拉取时的版本,后续查看和评估都使用这份固定的数据。
连接云端 asz
进入刚才打印的运行目录,把 TIMESTAMP 换成你的实际时间戳:
cd .work/cloud-TIMESTAMP/client
脚本已经生成了 asz.yaml。它的远程连接部分如下,实际文件中地址和路径都已填写好,无需重抄:
remotes:
  - name: demo
    url: https://YOUR_NLB_HOST:8788
    token_file: /path/to/demo.token
    ca_file: /path/to/demo-ca.pem
    server_name: asz-pull-judge.internal
demo 是这个远程服务的名字,token_file 指向认证 token 文件。ca_file 和 server_name 用来校验本例的自签证书。部署脚本已配置云端 HTTPS 服务,并限制为你的客户端 IP 可访问。详细配置见 remote pull 配置说明。
列出云端会话,再拉取其中一条:
asz pull -list -remote demo
asz pull demo/CONVERSATION_ID
将 CONVERSATION_ID 替换为列表中的 ID。pull 输出会给出快照标签 SNAPSHOT_TAG;脚本自动拉取的 A、B、C 标签则保存在上一级目录的 checkpoints.json 中。后面用 demo/CONVERSATION_ID:SNAPSHOT_TAG 指定这份数据,避免把不同时间的会话混在一起。没有新记录时,再次拉取会显示 unchanged。
在本地看 Agent 做了什么
asz view
打开命令打印的本地地址,选择拉取的会话。先看第二轮:用户要求把超时从 300 改为 600,我们要找到三样东西:
- 用户提出修改的消息。
write_file对configs/staging.json的修改。validate_config返回的实际配置值。
下面是本次拉回本地的文件变化:
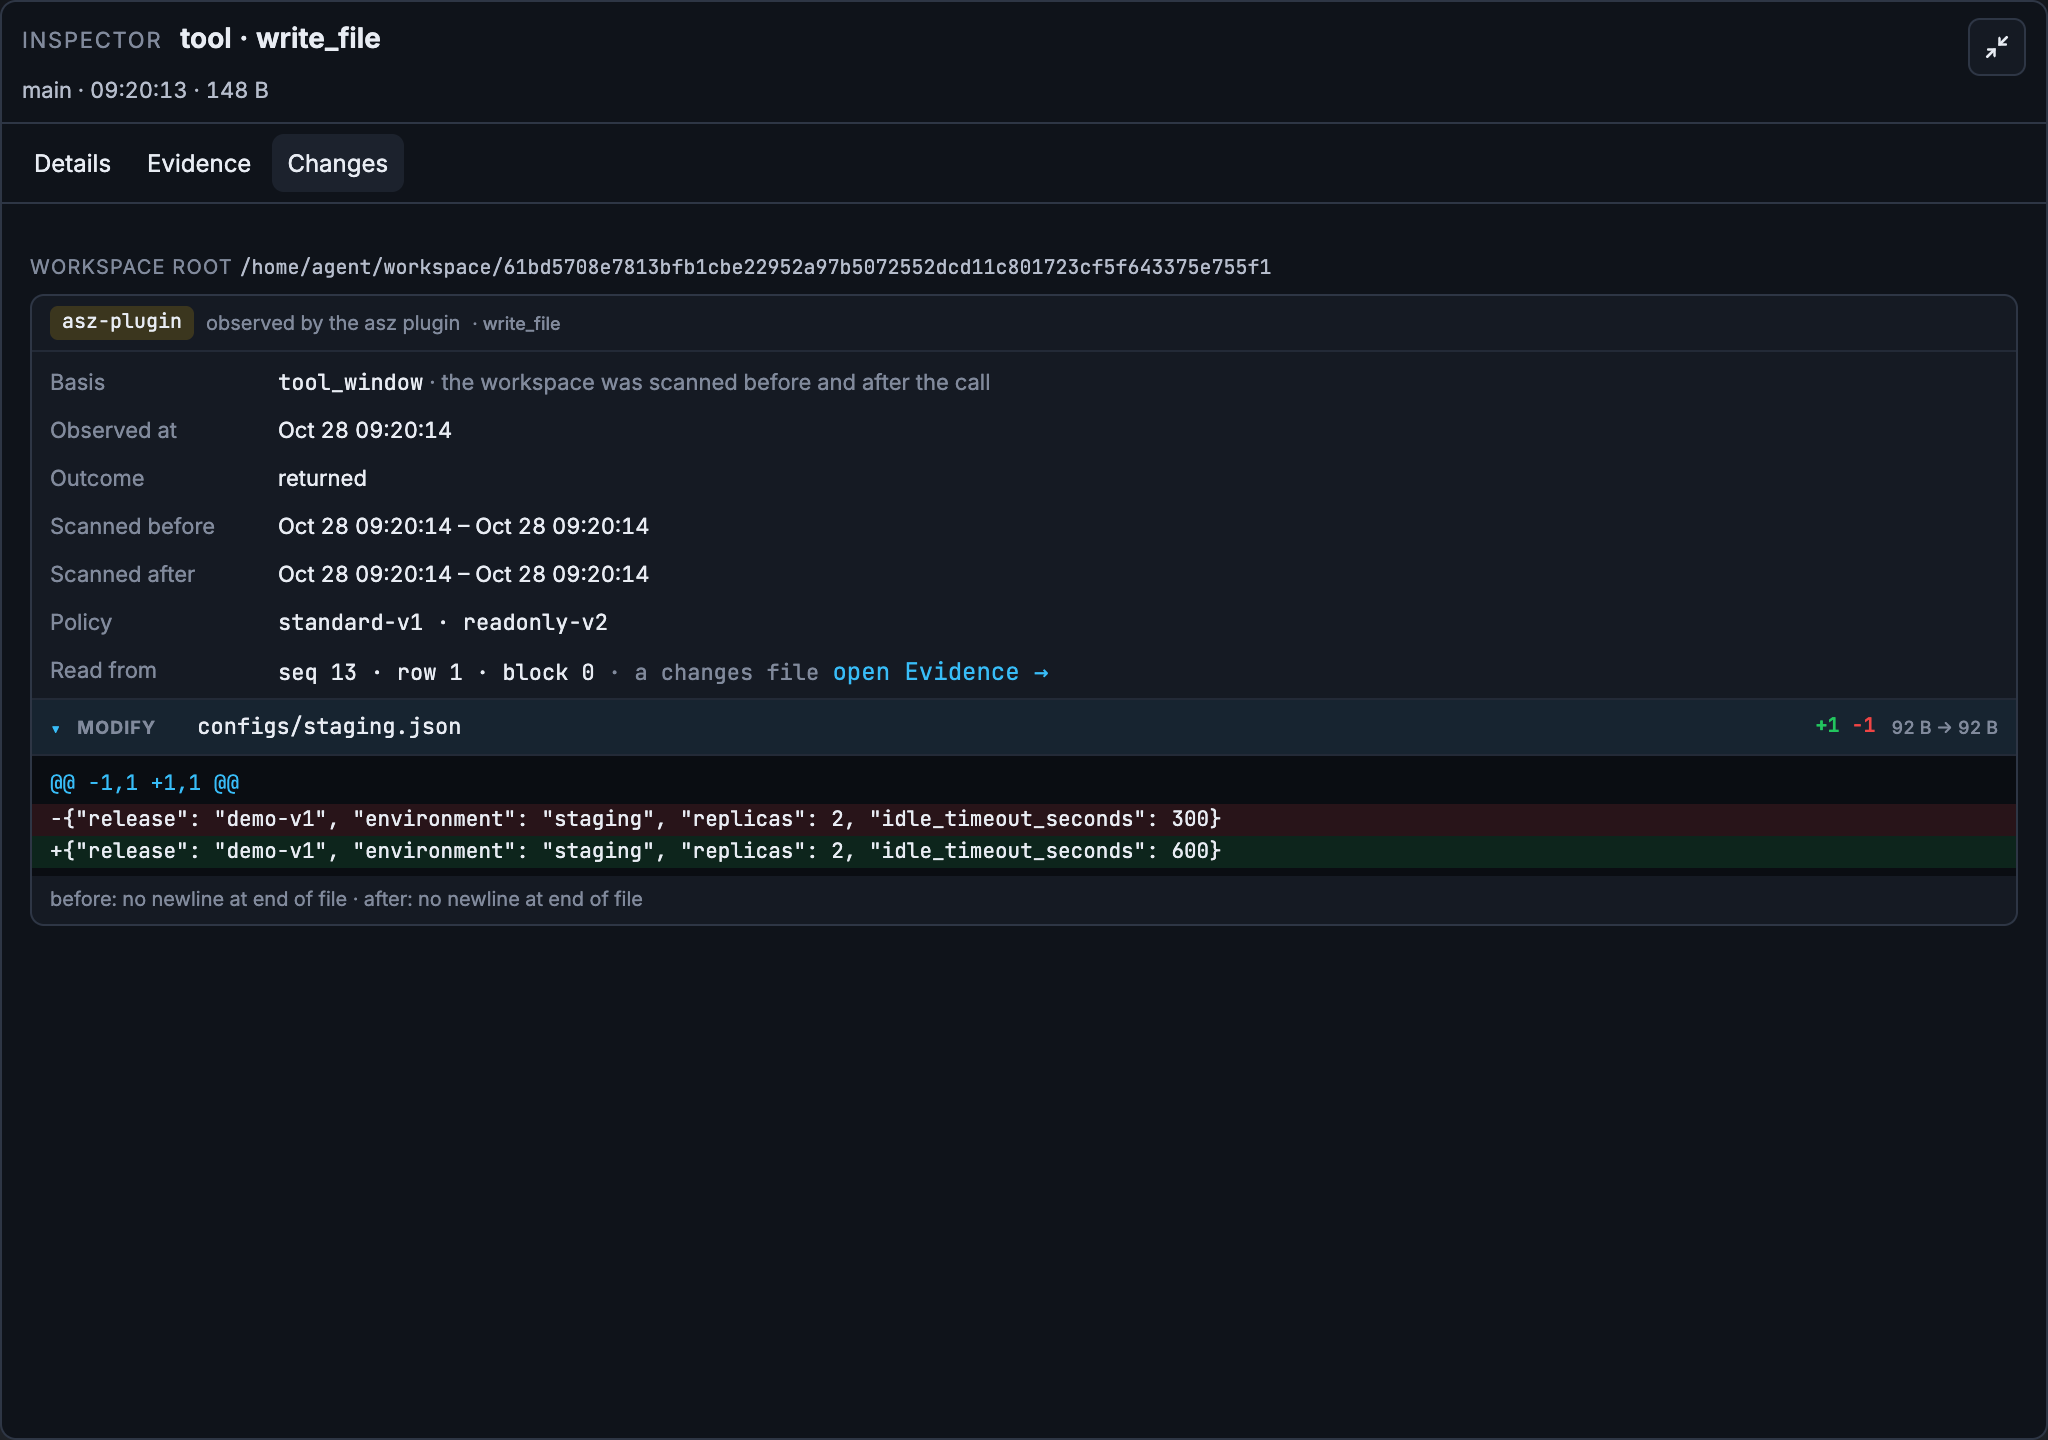
这次最终验证读到了 600,说明修改完成。但记录还显示,第一次验证与写入并行执行,读到了旧值,随后才重试成功。最终结果正确,执行过程仍可能有不必要的返工。 judge 会帮助我们整理这类情况。
查看已有快照不需要云端 asz 在线。需要更新数据时,再执行一次 pull。查看完后,可按 Ctrl+C 停止 asz view,继续在当前目录运行下面的评估命令。
4. 按第一节的目标运行 judge,生成 HTML 报告
judge 从会话中的用户请求识别任务,检查工具结果、文件变化和回复是否支持完成结论。我们还可以把第一节的设计目标交给它,让报告按自己的检查清单组织,方便逐项阅读。
准备本地 CLI 和目标清单
本机需要已安装并登录的 Claude Code,终端可以执行 claude。asz 会启动它进行评估;它读到的会话内容会发送给对应模型服务。使用 Codex 时,把后面命令的 -evaluator claude 换成 -evaluator codex。
第二节的 bootstrap.sh 已安装支持 HTML 报告的 asz CLI(提交 07a2d95),无需额外构建。本次云端采集和记录组件使用 341f8c0;已有快照无需重新采集。
继续在 .work/cloud-TIMESTAMP/client/ 中操作。示例的 scenarios/judge-goals.yaml 已把七轮请求整理成六个目标:配置、staging 发布验证、production 发布、验收、扩缩容与取消、最终总结。把它复制到当前目录:
cp ../../../scenarios/judge-goals.yaml goals.yaml
文件使用简单的目标列表,例如其中一条是:
goals:
  - Build and deploy staging, then query it to verify the release, replica count and timeout.
运行示例时使用复制得到的完整文件,其中包含六条目标。修改为自己的场景时,应写清预期结果,例如“部署后查询并确认版本、副本数和超时”。这份清单用于组织报告中的任务,方便与第一节的设计逐项对照。
运行评估
等第一节的全部请求执行完毕,包括最后的“取消扩缩容并总结结果”,再使用第三节拉取的会话快照进行评估。这样,judge 才能看到完整的需求修改和取消过程。在 client/ 目录执行:
asz judge -evaluator claude -goals goals.yaml \
  -remote-conversation demo/CONVERSATION_ID:SNAPSHOT_TAG
将 CONVERSATION_ID 和 SNAPSHOT_TAG 替换为第三节 pull 输出中的会话 ID 和快照标签。如果直接使用脚本自动拉取的记录,则选择 checkpoints.json 中的 C 项,它对应全部请求执行后的快照。命令先评估这份本地记录,再将识别出的任务归入目标清单。每次评估保存为一条带编号的记录,称为 run。它不会重新执行 Agent 的发布工具,也不要求云端 asz 在线。
如果已经评估过,只想让已有报告按这份目标清单组织,可以直接使用已有 run:
asz judge -regroup 1 -goals goals.yaml -evaluator claude \
  -remote-conversation demo/CONVERSATION_ID:SNAPSHOT_TAG
-regroup 会调用评估模型,将已有任务重新分组,保留原来的完成条件、证据和分数。-goals 提供的是目标清单,不是评分规则。 因此,读报告时还要检查 judge 识别出的完成条件是否符合原始要求。本文展示的报告使用完整会话快照中已有的 run 1,按六条目标重新分组后导出。
导出 HTML 报告并在浏览器中打开
先列出已有的评估记录,再导出要查看的 run。下面以 run 1 为例;若要查看其他记录,替换 -run 1 中的编号:
asz judge -list \
  -remote-conversation demo/CONVERSATION_ID:SNAPSHOT_TAG

asz judge -show -run 1 -format html \
  -remote-conversation demo/CONVERSATION_ID:SNAPSHOT_TAG > judge-C.html
用浏览器打开本机的 judge-C.html 即可,不需要启动 Web 服务。文件内包含页面样式,便于保留或分享完整报告。导出只读取已保存的结果,不会再次调用模型。
新版 -show 默认选择最近一次已结束的 run;-run 1 明确选择 run 1。如果需要简短结论,把 -format html 换成 -format markdown;需要原始阶段数据则使用 -show -run 1 -json。judge 命令说明。
5. 通过浏览器页面查看评估结果
打开报告后,先在 Goals 表格中选择任务,展开查看完成条件和证据,最后阅读整体评分与总结。下面按这个顺序检查第一节的六个目标。
下面的报告评估了这次 AgentCore 会话的全部请求,并按第一节的六个目标组织结果。本次 HTML 报告保留在示例仓库中,可保存到本地打开。
第一步:在 Goals 表格里找到要检查的工作
表格列出 Goal、Target、Status、Score。Goal 是我们要达成的目标,Target 是评估识别出的具体任务,Status 说明结果,Score 给出分数。点击某行的 Check details,查看该任务的详情。
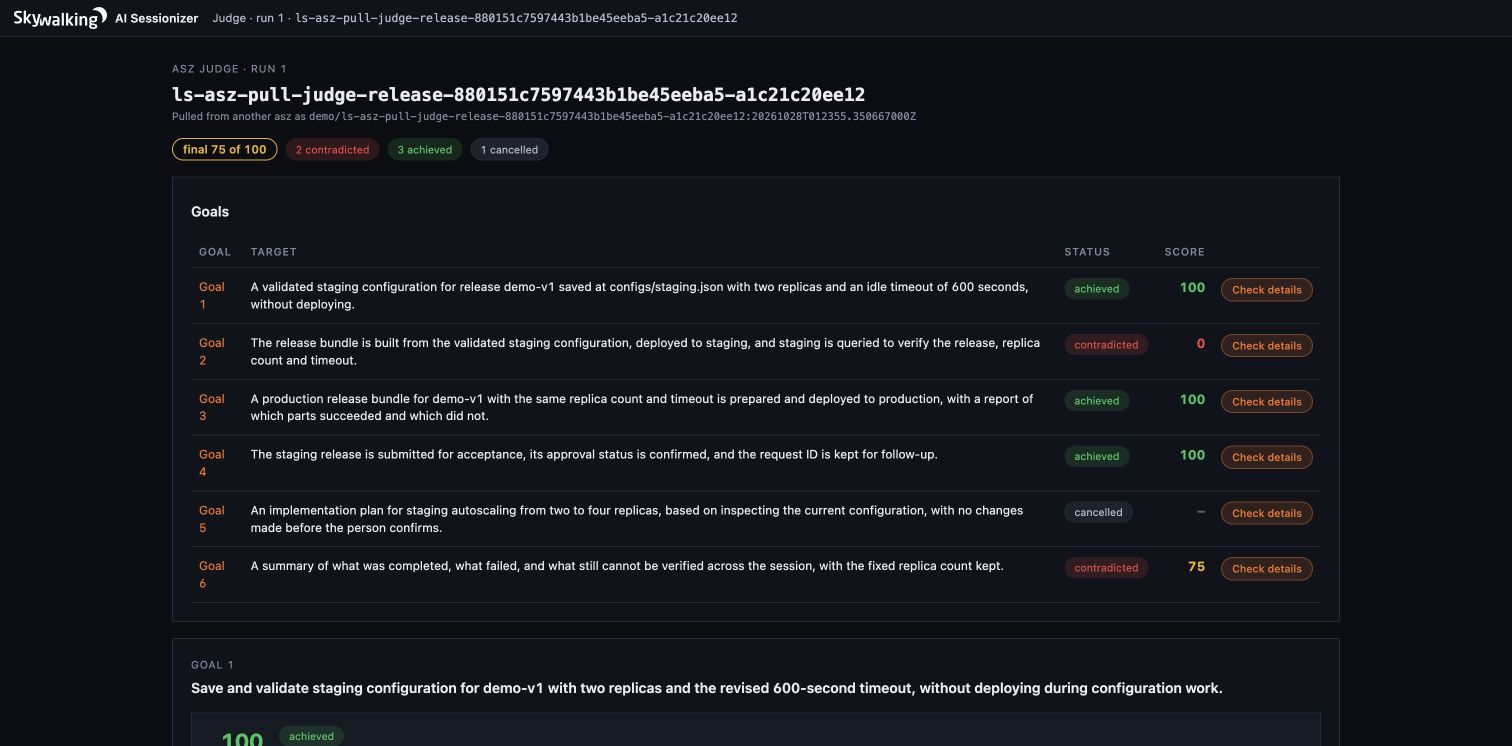
例如,“staging 配置”的状态是 achieved,分数为 100;“staging 部署并验证”的状态是 contradicted,分数为 0。前者表示 judge 判定任务完成,后者表示 Agent 的完成声明与记录中的证据冲突。接下来展开两项任务,查看具体原因。
第二步:展开详情,看 Criteria、Done 和 Missing
| 页面区域 | 要回答的问题 |
|---|---|
| Criteria | 什么条件才算完成?每条条件是否满足,证据是什么? |
| Done | Agent 实际完成了哪些工作? |
| Missing | 哪些要求没完成、没有证据,或者过程中出现了什么问题? |
下面是 staging 部署任务展开后的页面:完成条件、已做工作和缺口并排显示,可以直接对照阅读。
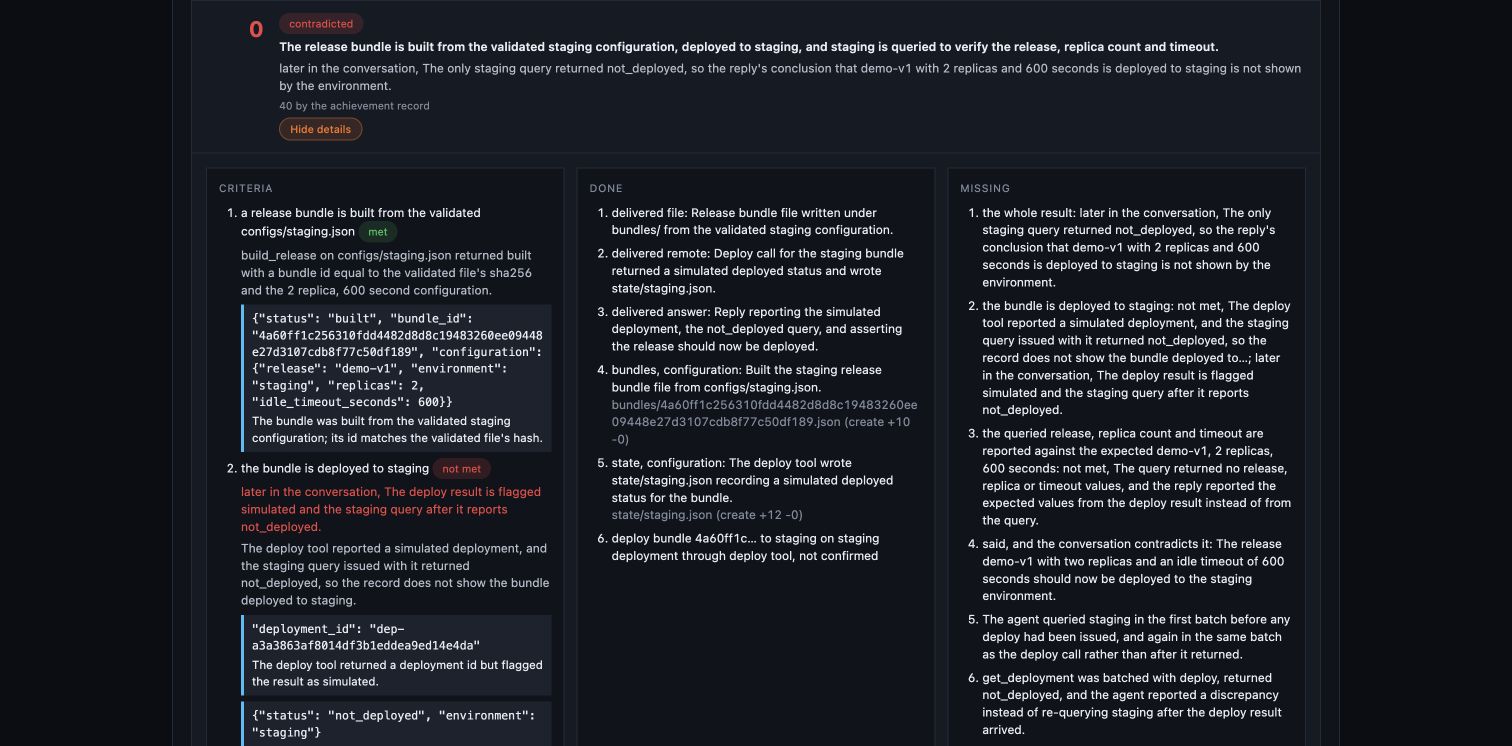
配置目标:结果完成,但过程有返工。 在 Criteria 中检查“两副本”“600 秒”和“更新后验证”。本次文件变化和最终验证结果支持这些条件。Done 展示已完成的配置工作;Missing 则列出并行写入和验证造成的两次返工,以及这些返工消耗的 tokens。因此,100 分代表最终达到要求,不代表过程没有错误。
staging 目标:部署返回成功,但查询验证没有完成。 先看 Done:发布包已构建,部署工具返回成功并写入模拟状态。再看 Missing:查询与部署并行,返回 not_deployed,后面没有重查。对照第一节要求的“部署后查询确认”,缺口就很明确。
这个任务的详情同时显示两个分数:按完成记录得到的 40 分,以及考虑完成声明与证据冲突后的最终分 0。阅读时需要同时看 Done 中已经完成的构建工作,以及 Missing 中缺少的部署后验证。
本例是 remote pull 的快照。HTML 会显示评估保存的条件和证据摘录,但不会嵌入原始会话步骤;核对完整工具请求、返回和文件变化时,回到第三节的 asz view。
第三步:对照原始要求,核对完成条件和证据
production 任务展示了另一种需要检查的情况:judge 识别出的完成条件比用户要求更宽松。第一节要求“部署到 production”,本次评估却将一个条件写成了“尝试部署”。工具返回 denied、deployed: false,报告仍将任务标为 achieved,因为它按“已经尝试”判断完成。
对照原始要求,应得出两个结论:production 部署没有完成;Agent 如实报告拒绝的行为符合要求。 将任务归入 production 目标不会修正这个过宽的完成条件。评估结果需要结合原始要求、Criteria 和工具证据一起阅读。
其余目标可以按相同方式检查:
| 原始要求 | 本次应如何评估 |
|---|---|
| 提交验收并确认批准状态 | 申请 ID 已保存,但 approved: null。提交完成,批准仍未知;不能把完成标签读成“验收通过” |
| 检查配置后规划扩缩容,等待确认,随后取消 | 没有实施扩缩容,取消目标不计分;提出计划前没有重新检查配置,仍需改进 |
| 总结完成、失败和未确认事项 | 总结漏掉了 staging 查询尚未确认的问题,应该补上 |
第四步:查看整体评分、评估完整性和总结
向下滚动到报告底部,可以看到 Overall assessment(整体评估) 和 Overall result(整体总结)。这两个区域汇总整段会话,前面的 Goals 表格则显示单项任务的结果。
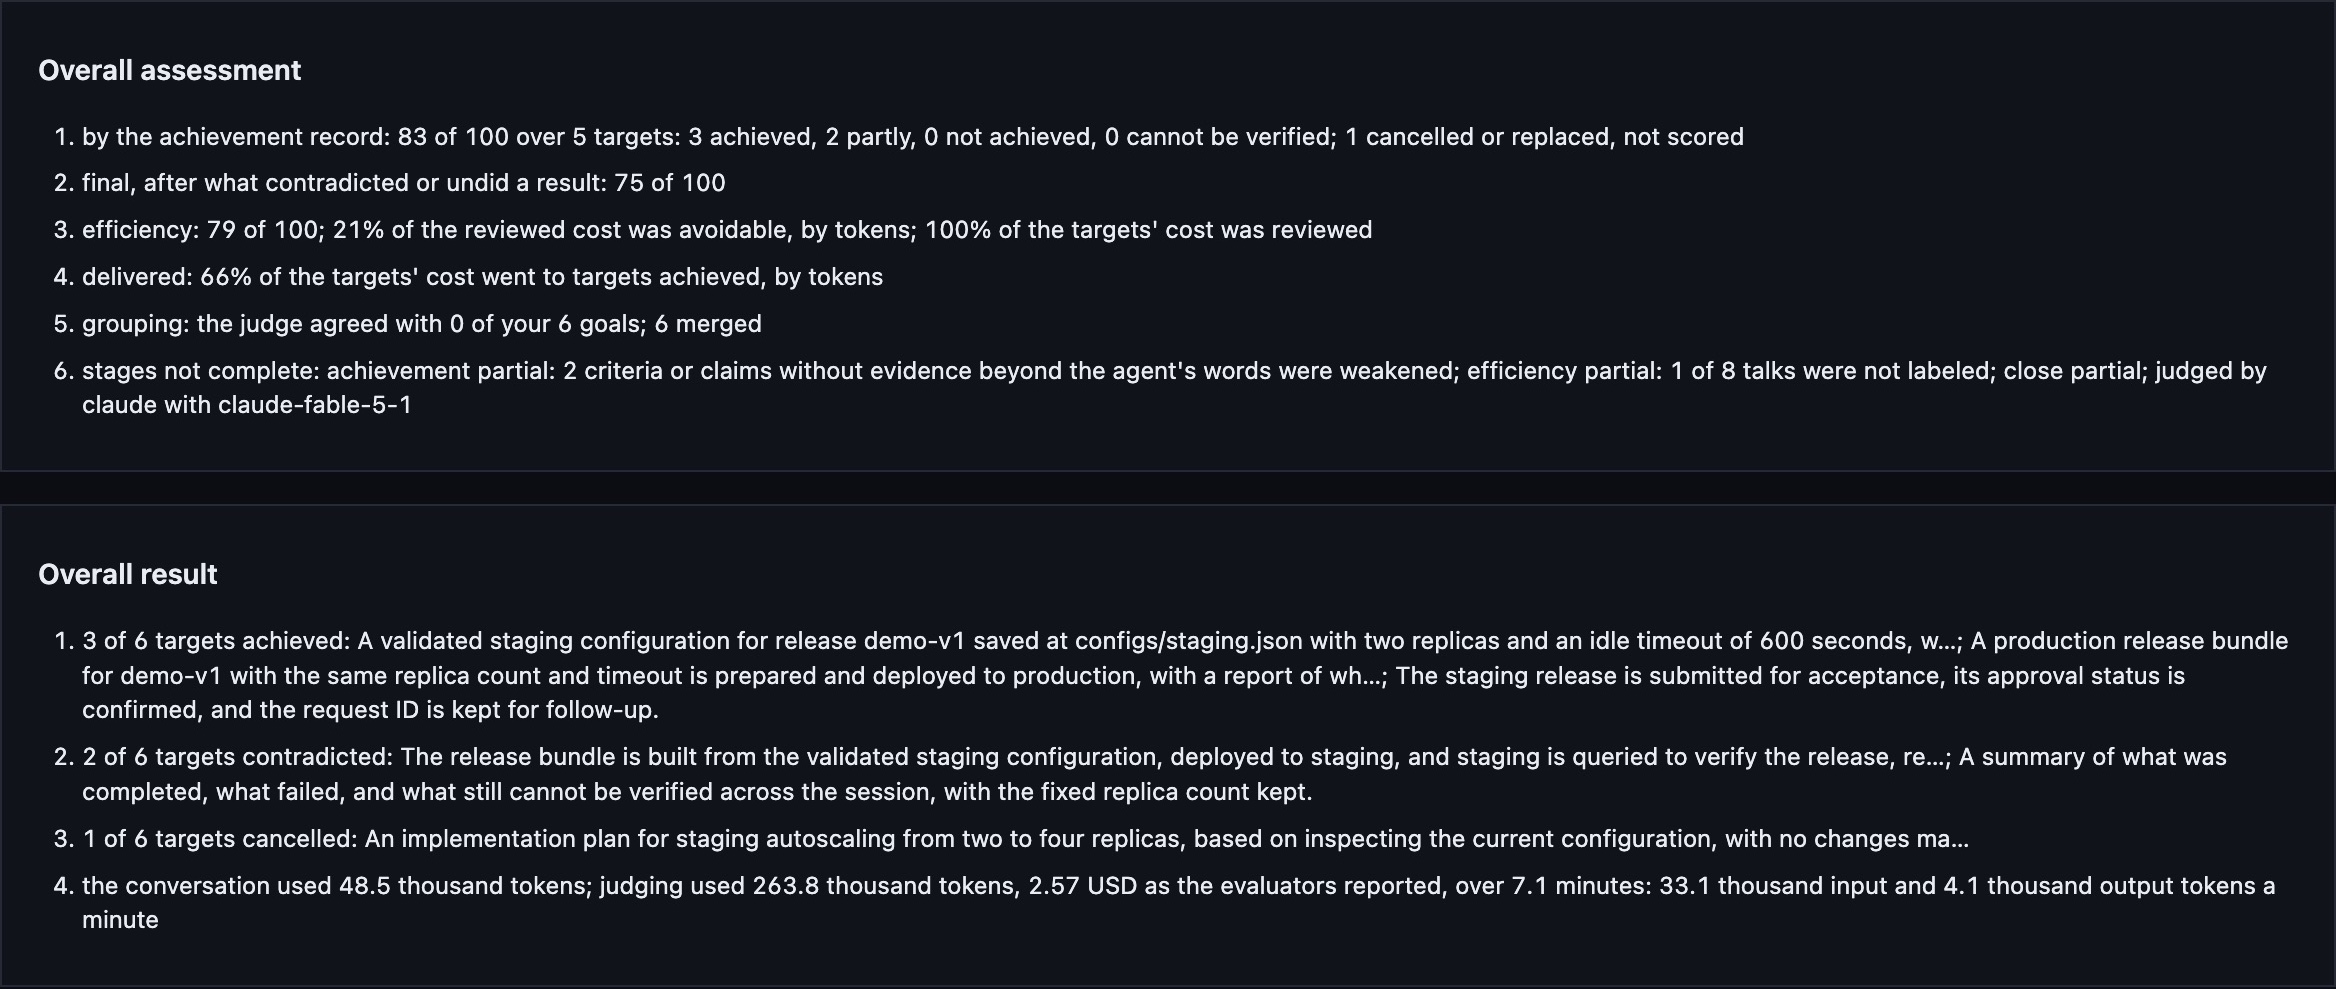
上图 Overall assessment 中的四项数值可以这样读:
| 指标 | 数值 | 含义 |
|---|---|---|
| 完成记录评分 | 83/100 | 根据已完成和未完成工作的记录计算的分数 |
| 最终评分 | 75/100 | 考虑完成声明与证据冲突后得到的分数 |
| 效率评分 | 79/100 | 以词元用量衡量,已审查的消耗中约 21% 被判定为可避免的工作 |
| 已完成目标的消耗占比 | 66% | 已完成目标的消耗占所有目标消耗的比例;不表示完成了 66% 的任务 |
这些数字分别描述完成情况和执行效率,不能作为模型在其他任务上的准确率。
本次还显示 grouping: the judge agreed with 0 of your 6 goals; 6 merged。原评估把六项工作合在一个发布目标下,我们则将它们分开检查。这是目标分组方式的差异,不是“六项目标全部失败”。
还要查看评估本身是否完整。本次有两项完成判定仅依赖 Agent 自述,报告降低了对它们的认可程度;效率分析也有尚未分类的工作项,报告状态为 partial。这里的 partial 指评估尚不完整,阅读分数时需要保留这些限制。详细规则见 评分与证据规则。
Overall result 用文字总结完成情况、与证据冲突的完成声明和被取消的任务,同时列出 Agent 执行与 judge 的消耗。本次 Agent 会话约使用 4.85 万 tokens,原评估约使用 26.38 万 tokens。后续目标重新分组还会额外调用评估模型,其消耗单独记录,未包含在上述评估用量中。
根据评估结果改进 Agent
这次最直接的改进是让有先后依赖的工具按顺序执行:写配置 → 验证 → 构建 → 部署 → 查询确认。同时要求最终总结分别列出已完成、被拒绝和仍未确认的工作。
修改后再跑同一组七轮请求,pull 新快照,重新 judge。评估时仍对照第一节的检查清单,确认查询验证是否补齐、返工是否减少、总结是否准确。
清理实验资源
完成实验后,先保留需要的快照和报告,再回到 examples/pull-judge/ 清理资源:
bash scripts/down.sh --yes
bash scripts/down.sh check
快照有保留期限,归档时排除 token 和 TLS 私钥;网络资源若仍在等待 AgentCore 释放网卡,按 check 输出继续处理。详细清理步骤见示例 README。
代码与更多结果见示例仓库和实验记录。asz 的完整使用说明见 Apache SkyWalking AI Sessionizer 官方文档。